顯示具有 機械學習 標籤的文章。 顯示所有文章

2019年3月9日 星期六

Berry Conda

不過是深度學或是機器學習,不少人建立了model之後,選擇佈署(deploy)在raspberry pi上,不過現在就算是最新的raspberry pi 3 B+,多數符合能執行的套件仍是32bit,其ARM硬體架構也常常跟訓練模型時的不一樣,這導致佈署十困難重重。
例如大家很喜歡的conda,可以把本來很難裝的套件一個指令就裝好了,但在raspberry pi上Anaconda是不支持的,網路上不少人推薦miniconda,當然也是很好的選擇,不過python3的版本是3.4,甚至比官方的python3.5還低,總是有點不舒服的感覺。
現在除了miniconda之外,有個更棒的選擇了: berryconda!!!!

Github連結在此: https://github.com/jjhelmus/berryconda

以raspberry pi 3 B為例來看看怎麼裝:
先下載檔案:
$ wget https://github.com/jjhelmus/berryconda/releases/download/v2.0.0/Berryconda3-2.0.0-Linux-armv7l.sh
之後安裝:
$ bash Berryconda3-2.0.0-Linux-armv7l.sh
最後加入路徑:
$ export PATH="/home/xxxxxx/berryconda3/bin:$PATH"
注意上面xxxxxx只是舉例,看看您是裝到哪個路徑要記得改。

最後輸入以下指令,使conda馬上生效。
$ source ~/.bashrc
應該完成了,可以試試conda的版本:
$ conda --version
conda 4.3.22
含有最重要的python版本
$ python --version
Python 3.6.1
是3.6.1喔.....

還真不錯,之後就可以在raspberry pi中使用conda囉~~~


參考網站:
https://www.jianshu.com/p/ccad38dbb897


python 2 or 3?

現在是2019年了
各位沒有看錯文章標題.........
或許答案顯而易見
我想多數人一定是回答python3,特別是對新手而言
不過真的有時還是會有無奈的選擇時候
像我最近寫了個machine learning的code,但依賴的包實在不好裝
偏偏這個函式庫非常重要,無替代方案
搞了快一個星期只好放棄
所以只好回去使用python2
沒辦法,自己功力不夠從最基本的開始寫
所以有時看別人使用python2不要覺得是old school,實在還是有不得已的時候啊

2018年6月18日 星期一

Machine Learning: Polynomial Regression 多項式迴歸

線性迴歸(Linear Regression)是機器學習(Machine Learning)中常用且基本的model之一,但Sckit-Learn中線性迴歸不僅僅只是能處理線性資料,也能以簡單的方式以多項式迴歸(Polynomial Regression)對資料做擬合(fitting)。換句話說,也就是不儘是線性函數:
y = ax + b

也能以多項式擬合(fitting):
y = ax + bx^2 + cx^3+ ........

怎麼做呢? 基本上就是山不轉路轉,動不了特徵值,換個x值總可以吧。

來看看實際例子:
先import會用到的module:
其中PolynomialFeatures就是轉換座標的關鍵函式(Polynomial basis functions)。

舉例來說,若我本來輸入的x值是2,4,6,此函式就會幫我們轉成2次、3次等等。
只要利用.fit_transform就可以輕鬆達成!!!

看一下實際例子吧,假如我們有下列的資料:
這一看就明顯不是"線性",反而像正弦之類的函數,我們這邊嚐試利用多項式來解,
利用剛才的工具:

我們調用了sklearn.linear_model的LinearRegression,並用較高階的語法make_pipeline直接把x值轉換與模型建立一次完成了。注意在PolynomialFeatures中,我們使用到六次項(6)。

接著擬合剛建立的模型(poly_model)poly_model.fit(),其中xfit是我們自己建立的x值:
得到yfit後,再畫出本來的資料與得到的model,看來結果還不錯囉!!!

參考資料:https://jakevdp.github.io/PythonDataScienceHandbook/


2018年1月29日 星期一

Keras: CNN辨識Cifar-10

CIRAF-10資料集是一組影像辨識的資料集,共有十種分類(包含有鳥、貓、汽車、卡車等等圖片,因圖片是彩色,雜訊多(有時連人都難以辨認),所以辨識難度比之前的MNIST高得多。我們接下來就以CNN(Convolution neural network)建立模型,進行CIRAF-10資料庫的辨識。
CNN一般來說比先前的基礎ANN多元感知器能達到更高的準確率,利用卷積層及池化層能提取圖片的特徵,增加辨識的能力,CNN的基礎理論從這裡可以看到不錯的介紹,所以就不囉嗦,直接來看看Keras程式吧。
先import需要的資料庫及CIRAF-10資料集,因Keras已內建,可以直接使用cifra10.load_data()的指令讀取:

另外開一個dictionary(label_dictionary)儲存每一個label數字代表的類別(共十種)。

看一下download的內容:

可以知道有訓練圖形(image)資料50000筆,驗證(Test)資料則有10000筆,每一筆資料為32x32的矩陣,最後一個維度是RGB三原色三個數字,代表圖素的顏色。標籤(label)的資料則有一個數字表示圖片的類別。

我們可以看一筆資料中的一個畫素:
(159, 102, 101)各代表RGB三原色的數字大小,可進一步看圖片:
是一台紅色車子,預期標籤應該是1(注意程式中已利用dictionary轉換標籤了)。

接下來進行數據的預處理,同樣包含了設定類型(float32)並標準化以提升準確率,可以看一下第一筆資料的第一個圖素,確定有沒有錯誤:

另外有一點要注意的是,跟ANN有差異的地方在於資料轉換,MNIST原本資料是(60000, 28, 28),ANN轉換成一維的784個數字(看這邊),而CNN必須保持圖片二維的特性,之後才可以利用卷積層及池化層提取圖片的特徵。

標籤方面也是必需轉換成one hot encoding的型態(也一樣可以參考前篇):

接下來就是模型的設定了:

這邊不得不感恩Keras!讚嘆Keras!!!!把最困難的部分變得簡單極了,我相信只要這篇懂了,也知道CNN的原理,模型建立的程式根本是一塊小蛋糕了,除了每層的參數設定有點小變化,一點難度都沒有(不過程式跑得比較久就是)。

總結一下整個程式如下:

同樣地以圖表看看最後結果:

可以清楚看到大量使用Dropout(最後一次參數為0.5)確實可以降低overfitting的現象,train及validation的差異較小。

訓練完model之後,接著就是以Test的資料測試,同樣使用model.evaluate指令:
測試結果的loss為0.824而準確率(accuracy)約72.6%,相較於先前的MNIST資料集確實低很多,當然圖片為彩色且雜訊多應該是主要原因吧。

接下來就是進行預測囉,仍然利用model.predict_classes()的指令預測,
從結果看來前三筆預測結果分別是3,8,8,對照先前的dictionary分別為貓、船及船。同樣地直接看前三筆資料的圖檔會比較有真實感:

老實說,我還真不知道怎判斷第一筆資料是貓(cat)耶!

接下來仍然利用pandas的.crosstab指令產生confusion matrix(混淆矩陣),可以清楚哪些是正確預測的部分(對角線),哪些是預測錯誤的部分了。例如這次來看看標籤是0但預測成5的有8筆資料。


同樣地先建立下列標籤與預測值對照的完整表格,先看前三筆資料,跟先前的一樣,所以應該錯誤機率不大:

接下來看看哪些是標籤為0(飛機)但卻是預測為5(狗)的資料:

接下來print出第1898筆資料看看:
ㄟ.......這哪像狗了啊?一看就是飛機啊,只能說人工智慧跟人類思考還是不一樣,對照第一筆資料人類大概很難看出是貓,或許未來機器人跟人類的智慧還是互補的吧!!??


參考資料
TensorFlow+Keras深度學習人工智慧實務應用


2018年1月26日 星期五

Keras (預測)

(上一篇)我們已利用Keras建立模型、訓練及測試模型了,下一步當然就是要拿模型實際預測看看,因此我們利用model.predict()的指令預測,( )內的argument輸入測試的資料:

因為我們model設置的輸出函數是softmax函數,所以可以看到跑出來的是個array,裡面的每一listr就是當對應於一個圖片預測的機率,例如我們可以看一下第一個:

第八個元素值是0.9977....換句話就是99%的機率會是7。當然這種結果並不是很方便,所以我們可改用.predict.classes(),換句話就是輸出已分類(class)的結果:

這樣子很明顯第一筆預測結果是7,第二個是2,很直接了當。

當然這樣子看預測的結果還是虛虛的,有種不夠札實的結果的感覺,因此我們想真實"看"到結果,那就把最後預測繪出來好了:
這邊顯示了第340至ˇ342筆資料,其中可看到第340筆圖片是5,但預測值卻是3。

接下來利用pandas中的幾個功能進一步分析結果(關於pandas可看這連結),輸入.crosstab這指令,可以檢視兩種資料間的關係,此表格稱為confusion matrix(混淆矩陣),可以清楚看到在對角線的部分(數字很大)就是正確預測的部分,而其他預測值當然就是錯誤的部分了。例如標籤是4但預測成2的有5筆資料。

我們或許也想知道這5筆資料到底長得怎樣,先建立下列標籤與預測值對照的完整表格,先看前兩筆資料:

有了這個表可以看看哪些是標籤為4但卻是預測為2的資料:

接下來print出第247筆資料看看:
確實有跟2有87%像啊,也難怪會預測錯誤。


參考資料
TensorFlow+Keras深度學習人工智慧實務應用


2018年1月25日 星期四

初試Keras

Keras是架構在TensorFlow與Theano之上的高階深度學習庫,為開放原始碼,相較於TensorFlow與Theano低階的程式庫,使用Keras建構深度學習模型相對上會簡單許多,當然相對上犧牲的是會有比較多的建立模型的限制,不過對初學者(像我就是啦!!)來說,確實是值得學習的程式框架。

這邊(點這)有個人覺得不錯的Keras簡介,可以參考看看。
好啦!!話不多說啦!!學程式還是要親自動手才算數,就來試試看Keras囉!!這邊要做的是基礎的手寫數字辨識MNIST。

首先先把需要的module先輸入:

其中numpy跟pandas都是常用的module,而keras.utils則是keras的工具庫。

接下來下載MNIST資料庫:
可以用.shape的方法看看我們下載的內容,其中有訓練(train)的部分有60000筆資料,每筆資料是28x28的灰階矩陣,每張資料則有相對應的label,標示資料的正確數字。而相同的驗證(test)的部分則是有10000筆。

接下來先看看利用matplotlib第一筆資料到底長得怎樣:

 第一筆訓練的手寫資料是5,那如果想看看標籤呢? 這比較簡單,就一般array囉,那就一次來看前五個labels:
結果第一個果然是5。
接下來進行數據的前處理,首先把28x28矩陣以.reshape方法轉換成一維的向量,之後計算會比較方便,後面接著.astype則轉換成float32的資料型態:
可以print出來看看有沒有轉換成功(28 x 28 = 784),或直接印第一筆資料出來看看:

從結果看出來是沒有問題的(因資料太大,上圖只有一部分資料)。
不過最後還需做一個動作,把資料歸一化,避免資料運算數字過大,有助於提升準確率,因資料是從0~255(256個灰階),所以我們把資料全部除255,並顯示出來看看:
不過資料太大,只有簡略顯示一部份。

接下來就是label(標籤)的資料處理了,這部分比較複雜點,因統計的數據(data)分成兩大類:numerical和categorical,numerical有數量單位,而categorical則沒有數量單位,例如身高體重有單位(cm、kg),但血型只有數種,所以是categorical,簡單來說就是只有類別(category)。而MNIST最後的結果就是要分成十個不同的數字,換句話說我們想做的是分類,因此這邊使用了所謂的"One-Hot Encoding"的方式把10個數字轉換成有binary特徵的數值,所以這邊利用np.utils.to.categorical的指令將label轉成one hot encoding的型態:
print出來後可以發現是相對於5及7的one hot encoding。到這邊就完成label的處理了。

接下來是模型的建立,這邊就是Keras的強項,來看看怎麼做:

其中Sequential表示之後使用model.add的方式將神經元一層一層的往上加就可了,第一層是輸入層與隱藏層,使用Dense(是Keras中全連結線神經網路,就是每個node之間都會連結),有256個神經單元(units),輸入資料dimension為784(輸入層必要值),起始核心為normal,換句話說就是使用常態化的亂數起始權重(Weight)及偏差(bias)值,輸出函數則為Softmax。接下來就再簡單疊一層輸出層就可。model.compile則建立訓練參數,loss使用categorical_crossentropy的方式,optimizer則用adam的優化方法,一般分類問題則設定使用accuracy準確率評估模型。
最後使用model.fit的指令啟動訓練啦,模型資料會存在train_history裡,validation_split指的是有20%的資料會用在驗證(validation)模型之用,epochs表示分10次訓練週期,batch_size則是設定一批次的訓練資料,verbose(中文有報告的意思)設定2則是把訓練報告顯示出來(設定0就是不輸出;設定1則顯示進度條),最後執行後每一個epoch的accuracy與loss值。到這邊總算是完成整個過程~~(累死了)。

還一個有用的指令是.summary,可以看一下我們建立模型的摘要:

總結一下整個程式如下:

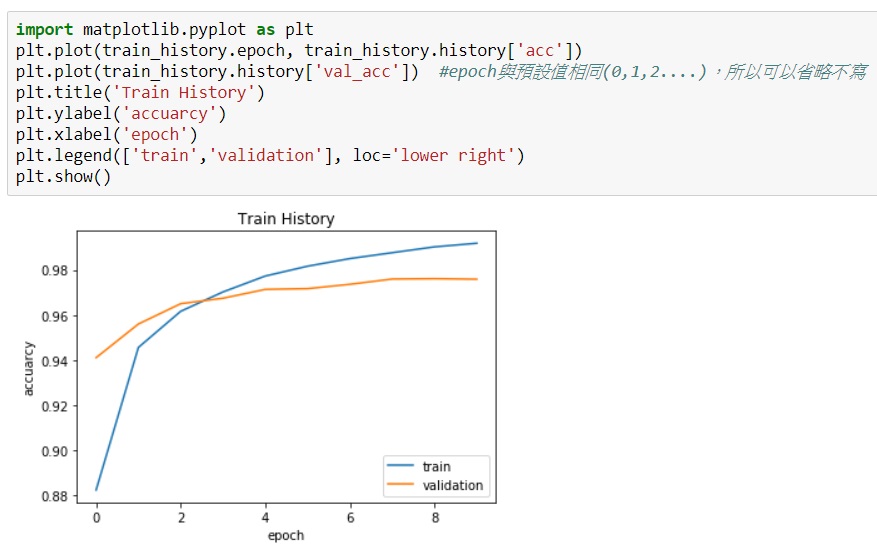
不過只看數字可能對模型比較沒感覺,所以還是需要作圖看看。上述提過最後的模型結果都存在train_history之中,我們先看看train_history是啥:


裡面有不少方法可以使用,例如.history:

裡面是個dictionary,分別存有'val_acc'、'acc'、'val_loss'與'loss',其實就是我們上面結果摘要的內容,另外還有.epoch:
有了這些data就可以繪圖了:

訓練完model之後,接著就是以Test的資料測試,這部份很簡單,使用model.evaluate指令:
看不懂結果?
這樣應該就清楚了,model.metrics_names很清楚告訴我們結果就是測試後的loss及accuracy,準確率達97.6%。


參考資料
TensorFlow+Keras深度學習人工智慧實務應用